搭载8路H800 NVLink GPU模组的大型服务器 开启数据处理新纪元
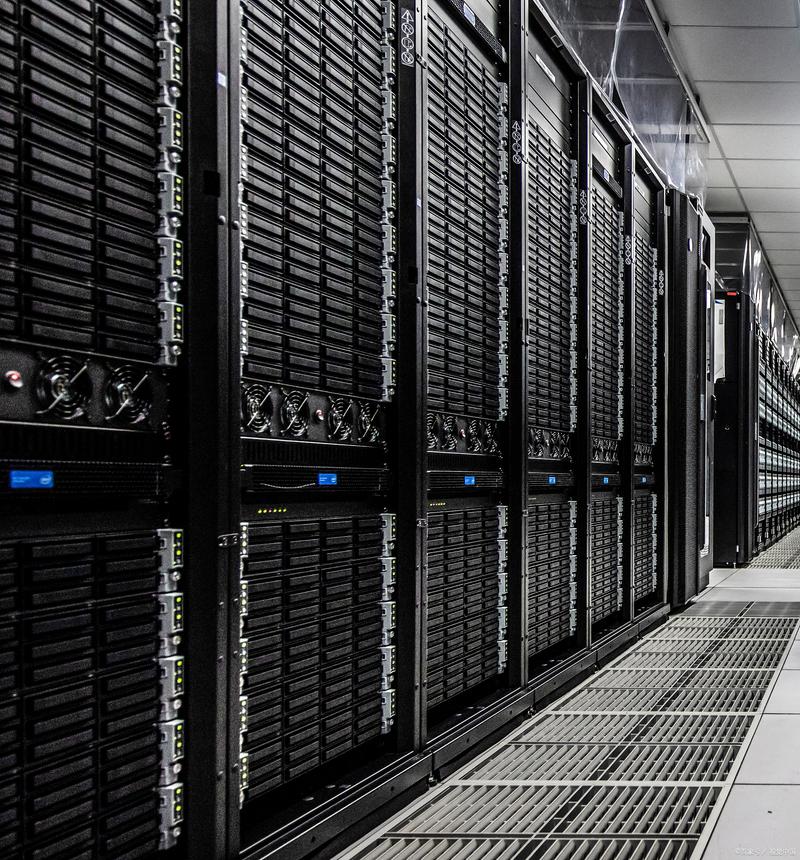
在人工智能与大数据爆炸式增长的时代,计算力已成为核心生产力。面对海量数据训练、科学模拟和实时推理等苛刻任务,传统服务器架构逐渐力不从心。而配备8个H800 NVLink GPU模组的大型GPU服务器,正凭借极致的并行计算能力和高速互联技术,重新定义数据处理的边界。
一、为什么是H800 + NVLink?
NVIDIA H800是专为大规模AI和高性能计算设计的GPU,采用Hopper架构,支持FP8精度和Transformer引擎,在训练千亿参数模型时表现出色。但单卡性能再强,若没有高效的协同机制,也难以发挥集群优势。NVLink是NVIDIA的高带宽、低延迟GPU互连技术,它允许多个GPU直接通信,绕过PCIe总线瓶颈。当8个H800通过NVLink模组全互联时,GPU之间可形成统一的共享内存域,带宽高达数百GB/s。这意味着,在模型并行、数据并行或流水线并行中, gradient同步、参数更新等操作不再成为瓶颈,计算效率成倍提升。
二、大型服务器:不只是堆叠GPU
将8个H800 NVLink模组塞进一台大型服务器,需要顶级的系统设计。主板采用多GPU基板,确保每个GPU获得充足的PCIe 5.0通道和电源供应。散热系统需应对高达数千瓦的功耗——通常采用液冷或高效风冷,避免热降频。电源必须提供冗余的高功率输出,并保证电压稳定。高速NIC(如InfiniBand或RoCE)实现节点间互联,NVMe存储阵列提供高达数十GB/s的吞吐,让数据喂给GPU永不挨饿。
三、数据处理服务的颠覆性变革
这类服务器直接服务于前沿数据处理场景:
- 大模型训练:8个H800可以协作训练百亿到千亿参数的大语言模型,NVLink加速全归约操作,将训练时间从月缩短到周。
- 科学计算:在气象预测、计算流体力学、分子动力学中,GPU并行处理数百万个网格点,NVLink支持跨GPU的灵活数据交换,实现更高精度的模拟。
- 实时推理:对于高并发的AI推理任务,8个GPU可划分成多个实例,或通过NVLink共享KV缓存,大幅提升吞吐并降低延迟,适用于自动驾驶、金融风控等场景。
- 数据分析和可视化:结合RAPIDS等GPU加速库,同类服务器能即时处理TB级数据集,交互式分析不再受限于I/O。
四、部署建议与挑战
要让8路H800 NVLink服务器物尽其用,需注意:
- 软件栈优化:使用CUDA、NCCL、TensorRT等,并确保深度学习框架(PyTorch、TensorFlow)支持NVLink P2P通信。
- 电力与冷却:单机功耗可能超过10kW,需专门的数据中心基础设施。
- 成本与可扩展性:虽然初始投资高,但相较搭建多台中端服务器,NVLink整机在能效比和通信效率上优势明显,可通过集群扩展至数千GPU。
五、未来展望
随着H800 NVLink模组服务器的普及,数据处理服务正从“云优先”向“混合算力”演进。企业可在本地部署此类超算节点,满足数据隐私和低延迟需求,同时与公有云弹性资源协同。可以预见,8路GPU模组的大型服务器将成为AI工厂的标准单元。
8个H800 NVLink GPU模组的大型服务器不仅仅是一个硬件集合,它是应对数据洪流的利器,是智能时代的计算基石。谁先驾驭它,谁就掌握了开启下一个数字纪元的钥匙。
如若转载,请注明出处:http://www.ufygx.com/product/54.html
更新时间:2026-10-11 02:01:07